Tecnologia • Inteligência artificial local
Dá para usar inteligência artificial no PC sem internet?
Você baixa um programa, desconecta o Wi-Fi e continua conversando com um modelo, transcrevendo áudio ou descrevendo uma imagem. A inteligência artificial está rodando no computador. Isso é possível — mas “offline” não significa automaticamente rápido, privado, gratuito ou equivalente aos maiores serviços em nuvem.
O resultado depende de cinco peças: o modelo escolhido, o hardware, a memória disponível, o programa que executa o modelo e o limite da tarefa. Entender essa cadeia evita dois extremos comuns: achar que qualquer notebook roda tudo ou concluir que IA local serve apenas para especialistas.
9 min de leitura • 13 min de áudio
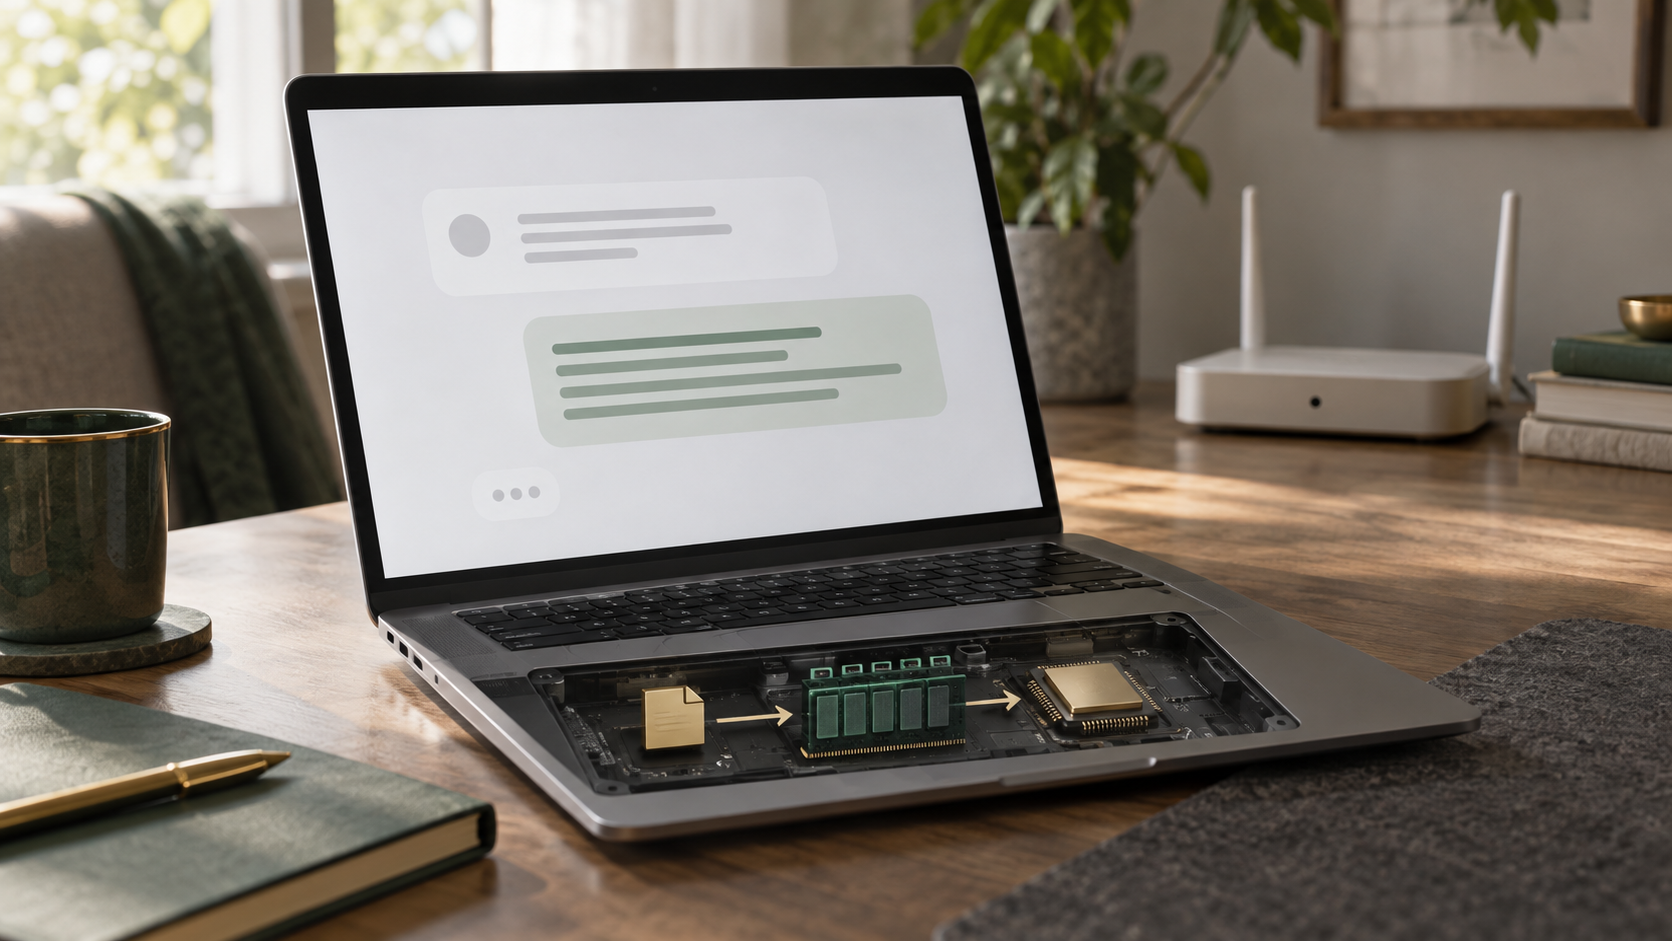
O modelo é o arquivo que precisa caber
Um modelo de linguagem contém parâmetros aprendidos durante o treinamento. Para responder localmente, parte relevante desses parâmetros precisa ser carregada na memória e processada pelo computador. Modelos maiores tendem a ter mais capacidade, mas exigem mais armazenamento, memória e processamento.
O nome do modelo não conta toda a história. Existem versões com tamanhos diferentes, ajustes para conversa ou código e formatos preparados para determinados programas. Há também modelos voltados a voz, imagem e classificação, que têm requisitos próprios.
Antes de baixar, confira três coisas: licença de uso, origem do arquivo e requisitos declarados. Repositórios falsos podem distribuir executáveis maliciosos usando o interesse por IA como isca. Prefira o site do projeto, o repositório oficial ou uma plataforma reconhecida, e verifique quem publicou a versão.
Quantização reduz memória — e pode aumentar a velocidade
Pesos de modelos podem ser armazenados com diferentes níveis de precisão numérica. A quantização reduz essa precisão para diminuir o uso de memória e acelerar a execução em certos hardwares. É como representar uma escala com menos casas decimais: o arquivo fica menor, mas alguma informação é aproximada.
Na prática, uma versão quantizada pode transformar um modelo inviável em algo utilizável num computador comum. A perda de qualidade varia conforme método, modelo e tarefa. Uma quantização mais agressiva economiza memória, porém pode piorar coerência, raciocínio ou fidelidade.
Por isso, “modelo de 8 bilhões de parâmetros” ainda não informa quanto de RAM será necessário. É preciso saber o formato, a precisão e o tamanho do contexto. O programa também usa memória para guardar o texto da conversa, buffers e outros componentes.
Memória costuma definir o teto
Se o modelo e seus dados de trabalho excedem a RAM ou a VRAM disponível, o executor pode dividir a carga entre diferentes memórias, o sistema pode recorrer à paginação no armazenamento ou a execução pode simplesmente falhar. Quando há muita paginação, o desempenho costuma cair bastante. Em máquinas com GPU dedicada, a memória de vídeo é especialmente importante. Em GPUs integradas e alguns sistemas com memória unificada, CPU e aceleradores compartilham a RAM, o que aumenta flexibilidade, mas também cria disputa com o sistema e outros aplicativos.
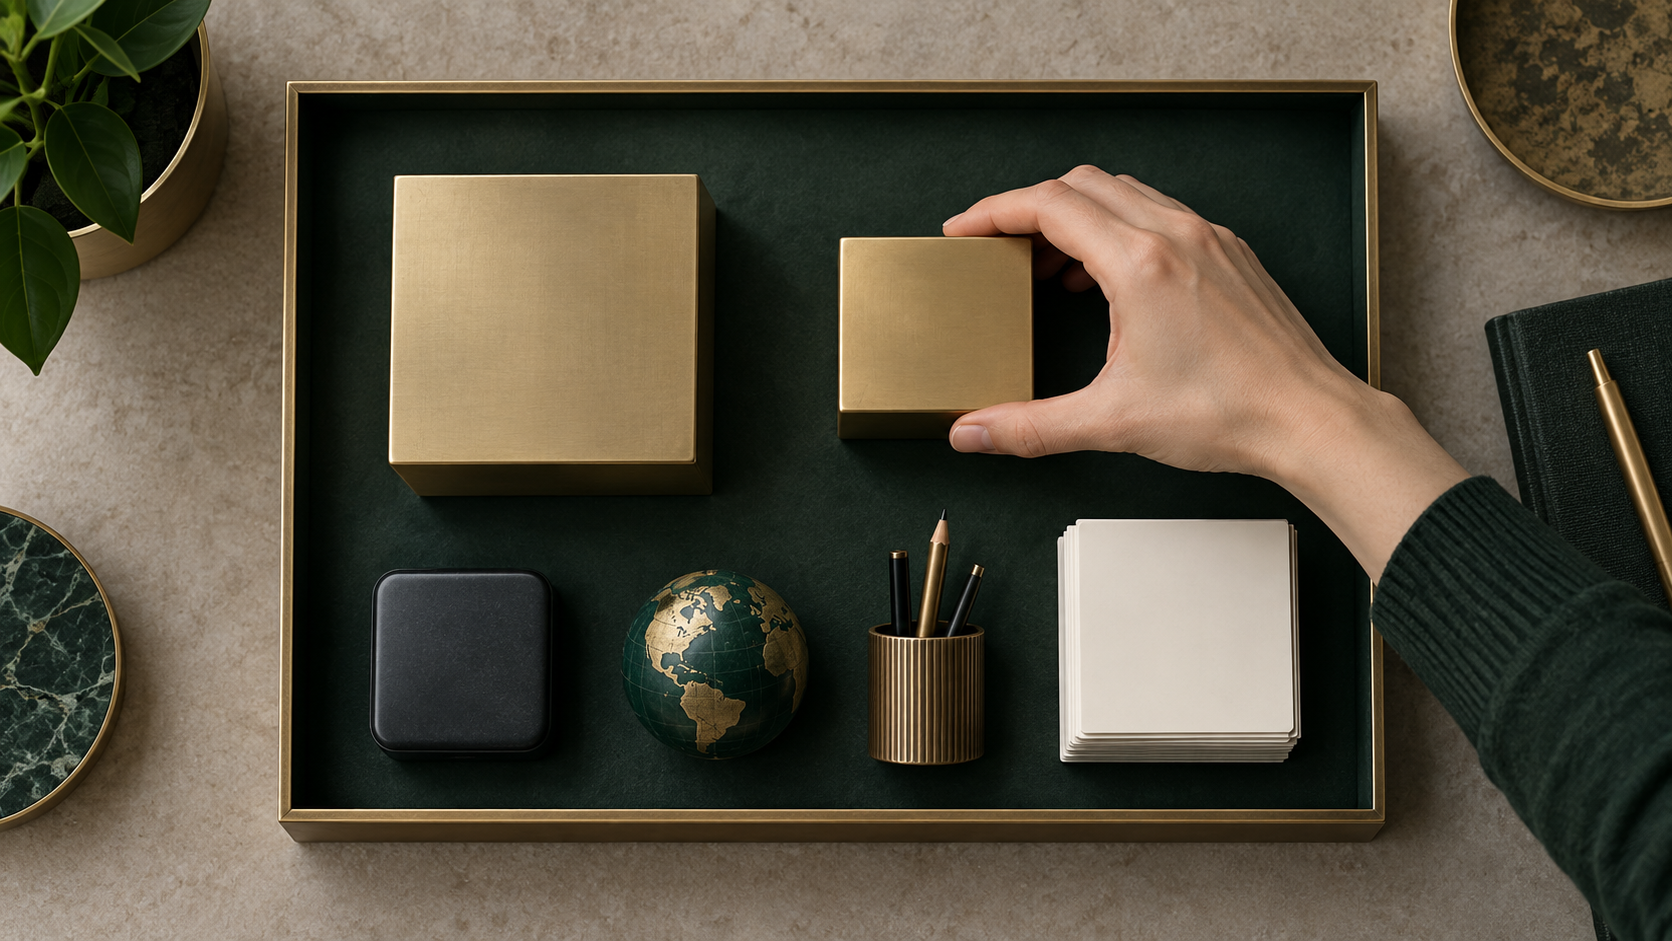
Imagine um notebook com 16 GB de RAM. O sistema, navegador e ferramentas de trabalho já ocupam uma parte. Um modelo cujo arquivo tem vários gigabytes ainda precisa de espaço adicional para operar. Fechar aplicativos pode ajudar, mas não muda o limite físico.
Para começar, escolha um modelo pequeno recomendado pelo executor local e monitore memória. Se houver travamentos, troca intensa ou resposta extremamente lenta, reduzir o modelo, a quantização ou o tamanho de contexto costuma ser mais sensato que insistir.
CPU, GPU e NPU têm papéis diferentes
A CPU oferece ampla compatibilidade e roda modelos pequenos, embora possa responder devagar. A GPU acelera muitas operações paralelas e costuma melhorar bastante geração de texto e imagem quando o software suporta seus drivers e há memória suficiente. A NPU foi desenhada para inferência eficiente, mas o suporte ainda depende muito do modelo, do formato e da plataforma.
Não presuma que o programa usará automaticamente todo acelerador disponível. Confirme na documentação quais dispositivos são compatíveis e observe o monitor do sistema durante a execução. Uma GPU potente ociosa enquanto a CPU fica em 100% costuma indicar configuração ou versão incompatível.
Essa divisão serve para encontrar o tamanho de modelo que sua máquina consegue sustentar. Ela também impede que uma sigla nova receba o crédito por um trabalho que, naquele programa, continua sendo feito pela CPU ou pela GPU.
Instalar é apenas o começo
Uma forma amigável de usar IA local é instalar um executor que gerencie modelos e ofereça uma interface de conversa. Outra é trabalhar por linha de comando ou integrar uma biblioteca ao próprio aplicativo. Em todos os casos, existem três origens que precisam ser avaliadas separadamente:
- o programa que executa o modelo;
- o arquivo do modelo;
- extensões, conectores ou interfaces adicionais.
Baixar um modelo confiável dentro de uma interface obscura não torna o conjunto seguro. Leia permissões, política de atualização e exposição de rede. Alguns programas criam um servidor local para que outras aplicações acessem a IA; se ele for configurado para aceitar conexões externas, deixa de ser apenas uma ferramenta isolada no computador.
Atualizações também importam. Bibliotecas que processam formatos complexos podem ter vulnerabilidades. Prefira projetos mantidos, use versões estáveis e evite executar comandos copiados de fóruns sem entender o que instalarão.
O teste offline precisa ser literal
Se a promessa é funcionar sem nuvem, faça o teste depois de concluir os downloads. Feche o programa, desligue Wi-Fi e dados cabeados, reabra e execute a tarefa. Observe se a resposta aparece, se alguma função fica indisponível e se o aplicativo tenta reconectar.
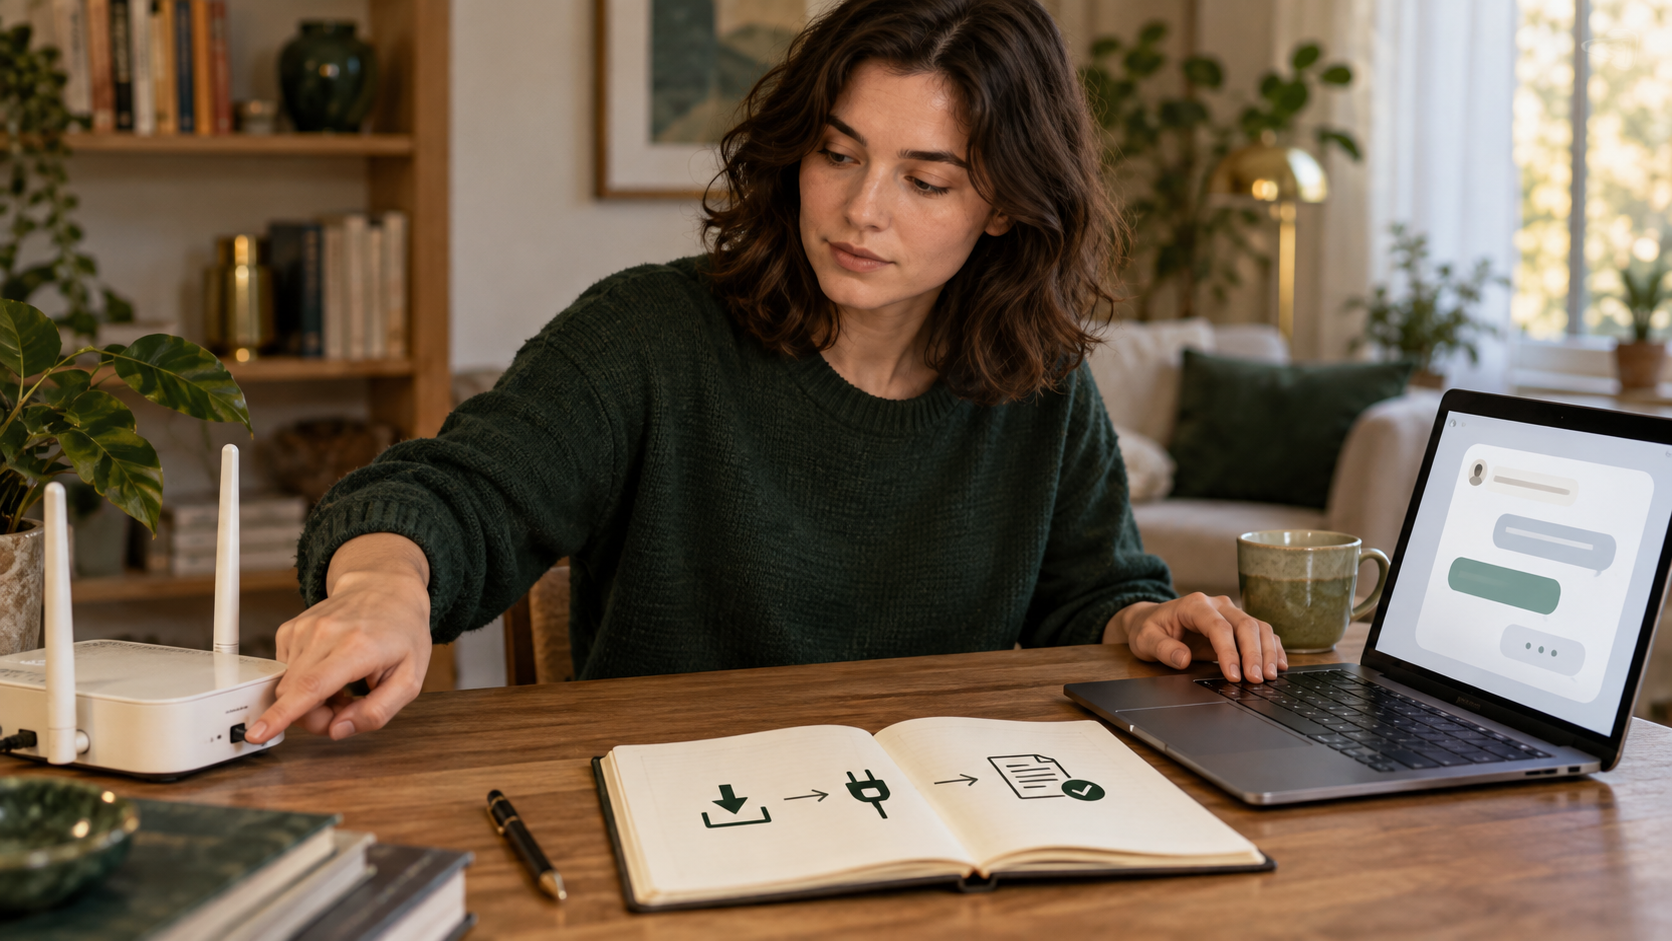
Um programa pode gerar texto localmente, mas buscar voz, moderação, telemetria, atualizações ou pesquisa na internet em serviços externos. Isso não é necessariamente errado. Apenas significa que “modo local” e “aplicativo inteiramente offline” são afirmações diferentes.
Ferramentas do sistema ou um firewall podem mostrar conexões, mas interpretar tráfego exige cuidado. Uma verificação de atualização não equivale ao envio do documento. A documentação de privacidade e um teste com arquivo controlado ajudam a formar evidência mais sólida.
Privacidade local tem limites físicos e humanos
Manter o conteúdo no PC reduz a exposição a servidores de terceiros e pode ser adequado para rascunhos internos ou documentos pessoais. Mas os dados continuam no dispositivo. Malware, conta sem senha, disco sem criptografia, backup mal configurado e outros usuários da máquina podem acessá-los.
Conversas podem ficar registradas na interface. Arquivos enviados para indexação podem gerar cópias, bancos vetoriais ou caches. Antes de usar material sensível, descubra onde esses dados são salvos, como apagá-los e se entram no backup.
Também não confunda execução local com confiabilidade. Um modelo offline pode inventar fatos, reproduzir vieses e interpretar instruções maliciosas em documentos. Ele não se torna correto por estar perto de você. Para decisões críticas, valide fontes e mantenha revisão humana.
O que funciona bem num PC comum
Modelos pequenos podem ser úteis para resumir textos já fornecidos, reorganizar notas, criar rascunhos, classificar conteúdo e auxiliar em código. Reconhecimento de fala local funciona bem em muitos computadores. Busca semântica em documentos pessoais também pode trazer valor, desde que a indexação seja controlada.
As limitações aparecem em conhecimento muito recente, pesquisas que exigem fontes ao vivo, contextos enormes, geração de imagem pesada e tarefas que pedem máxima qualidade. Um serviço em nuvem pode usar servidores com muito mais memória, modelos proprietários e ferramentas conectadas. A IA local troca parte dessa capacidade por autonomia, controle e funcionamento sem rede.
Um fluxo híbrido costuma ser melhor: material sensível e tarefas simples ficam no computador; pesquisas atuais ou trabalhos pesados vão para um serviço escolhido, depois de remover dados confidenciais quando possível.
A mesma diferença entre processamento local, nuvem e fluxo híbrido aparece nos celulares; o guia sobre o que fica no aparelho e o que vai para a nuvem ajuda a separar essas camadas.
Local não é necessariamente sem custo
Depois do download, muitos modelos podem ser executados sem cobrança por resposta, conforme a licença. Ainda há custo de hardware, energia, armazenamento e tempo de manutenção. Uma GPU dedicada sob carga consome mais eletricidade e produz calor; num notebook, isso reduz autonomia. Um serviço em nuvem dilui essa infraestrutura numa assinatura ou cobrança por uso.
Compare pelo volume real. Para poucas consultas por semana, comprar uma GPU apenas para economizar assinatura pode não fechar a conta. Para uso recorrente, requisitos de sigilo ou operação sem internet, o investimento local ganha outra lógica. Empresas também precisam considerar administração, atualização e controle de acesso, não apenas o preço da máquina.
A licença do modelo merece leitura: algumas permitem uso comercial, outras impõem condições ou restrições. “Código aberto”, “pesos disponíveis” e “gratuito para qualquer finalidade” não são sinônimos. A tecnologia roda localmente, mas os direitos de uso continuam vindo de quem a publicou.
Como escolher sem transformar o PC em laboratório
Defina uma tarefa específica, como transcrever uma entrevista de dez minutos ou conversar com três PDFs. Escolha um executor conhecido e um modelo pequeno indicado para o seu sistema. Registre o consumo de RAM, o tempo até a primeira resposta e a velocidade percebida.
Depois aumente uma variável por vez. Teste um modelo maior ou contexto mais longo, não os dois simultaneamente. Compare qualidade usando as mesmas perguntas. Se o resultado melhora pouco e o computador passa a aquecer, gastar bateria ou trocar memória, você encontrou um limite econômico.
Faça também o teste de desligar a internet e reiniciar. Apague uma conversa de teste e confirme se os arquivos relacionados desapareceram do local indicado. Essas duas ações verificam promessas que benchmarks de velocidade não medem.
Local não precisa imitar a nuvem
IA offline vale mais quando resolve uma tarefa delimitada: transcrever sem enviar áudio, consultar um conjunto privado de notas, classificar arquivos ou produzir um primeiro rascunho numa viagem. Ela decepciona quando é comprada como uma réplica gratuita e ilimitada dos maiores serviços remotos.
Comece pelo problema, encontre o menor modelo que o resolve e trate memória como orçamento. Verifique a origem dos programas e teste o funcionamento realmente desconectado. Assim, a IA local deixa de ser uma demonstração técnica e se torna uma ferramenta cuja capacidade e limites você consegue enxergar.
Fontes consultadas
- Microsoft Learn — Visão geral de IA no Windows
- Microsoft Learn — Perguntas frequentes sobre IA no Windows
- Microsoft Learn — IA na nuvem e IA local
- Google AI for Developers — Documentação do Gemma
- Google AI for Developers — Requisitos de memória dos modelos Gemma
- Hugging Face — Visão geral de quantização
- NVIDIA Developer — Fundamentos de memória de GPU para IA